
ソフトウェアファクトリーとは?2026年の動向と承認ゲート

ソフトウェアファクトリーは、AI エージェントが仕様を受け取って実装・テスト・出荷までを流し、人は「何を作るか」と「出してよいか」の判断を握る開発の仕組みです。2026 年に入ってから、コーディングエージェントを 1 本ずつ使う段階を越えて、工程全体を工場のように組む事例が相次いで公開されました。
この記事では、言葉の由来と 2026 年の主な動き、工場を構成する工程を整理したうえで、gaipack が人の承認ゲートをどこに残しているかを紹介します。
ソフトウェアファクトリーとは
ソフトウェアファクトリーという言葉は、生成 AI よりずっと古くからあります。2026 年の用法は、その古い構想をエージェント前提で組み直したものです。
1968 年から続く「工場」の構想
ソフトウェアを工場のように作るという構想は、1968 年に R. W. Bemer が General Electric 向けに提案したものが最初期の例とされています。翌 1969 年には日立製作所が「ソフトウェア工場」を設立し、1980 年代の日本の大手メーカーはこの方式で大規模開発を組織化しました。MIT の Michael Cusumano は、その実態を『Japan's Software Factories』(1991 年)にまとめています。
2004 年には Microsoft の Jack Greenfield と Keith Short が著書『Software Factories』で、ドメイン固有言語とテンプレートでアプリケーションを組み立てる手法としてこの言葉を使いました。どの時代も、標準化した工程に部品と手順を流して、品質と量を安定させるという発想は共通しています。
2026 年の再定義
2026 年の「ソフトウェアファクトリー」は、工程を動かす主体が人から AI エージェントに移った点が違います。コーディングエージェントの Droid を提供する Factory 社は、2026 年 6 月 15 日の「Factory 2.0」で、ソフトウェアファクトリーを「バグ報告や顧客の声といった外部のシグナルを受け取り、計画・構築・テスト・レビュー・出荷・監視までを通しで回し、その監視結果が次のシグナルになる、エージェントネイティブなシステム」と説明しています。エンジニアの仕事は、ソフトウェアを書くことから「ソフトウェアを作る工場を作ること」に移る、という位置づけです。
名前が似ている NVIDIA の「AI ファクトリー」は、AI の学習・推論を行うデータセンター基盤を指す言葉で、ここで扱う開発の仕組みとは別物です。また、IDE の中で 1 つのエージェントに実装を頼むだけでは工場とは呼びません。工場と呼べるのは、工程と検査の関門があり、各工程で何が起きたかが記録として残る状態です。
2026 年のソフトウェアファクトリーの動き
2026 年は、ソフトウェアファクトリーを実際に運用している組織が、その中身を公開し始めた年でした。主な公開内容を時系列で並べます。
| 時期 | 公開元 | 内容 |
|---|---|---|
| 2026 年 1 月 23 日 | Dan Shapiro | AI コーディングの関与度を Level 0〜5 に分類。Level 5 を「ダークファクトリー」と命名 |
| 2026 年 2 月 6 日 | StrongDM | 「人はコードを書かない・レビューしない」を規則とするソフトウェアファクトリーを公開 |
| 2026 年 2 月 9 日 | Stripe | 社内エージェント Minions が書いた PR が週 1,000 件以上マージされていると公開 |
| 2026 年 4 月 27 日 | OpenAI | Linear のチケットごとに Codex を割り当てるオーケストレーター Symphony をオープンソース化 |
| 2026 年 6 月 15 日 | Factory | Factory 2.0 として、シグナル起点で出荷・監視まで回すソフトウェアファクトリーを発表 |
| 2026 年 10 月 6 日 | GitLab | 「governed software factory(統制されたソフトウェアファクトリー)」の基盤となる機能群を発表 |
Level 0〜5 とダークファクトリー
起業家の Dan Shapiro は 2026 年 1 月の記事「The Five Levels: from Spicy Autocomplete to the Software Factory」で、AI コーディングへの関わり方を自動運転のレベルになぞらえて 6 段階に分けました。
| レベル | 人の関わり方 |
|---|---|
| Level 0 | 人がすべて書く。AI は検索や補完の補助 |
| Level 1 | 単体テストやドキュメントなど、切り出したタスクを任せる |
| Level 2 | AI とペアを組んで書く。Shapiro は「AI ネイティブな開発者の多くはここ」としている |
| Level 3 | 人はマネージャーとして、複数エージェントの差分をレビューして過ごす |
| Level 4 | 人は仕様とスキルを書いて計画し、エージェントを何時間も走らせてテスト結果を確認する |
| Level 5 | 仕様をソフトウェアに変えるブラックボックス。人が回す工程はない |
Level 5 の名前は、ファナックのロボット工場のように照明を消しても動く無人工場(ダークファクトリー)から取られています。Shapiro 自身、ほとんどの開発者は Level 3 で頭打ちになると書いており、Level 5 は到達点の名前であって、業界の標準ではありません。
人がコードを見ない工場(StrongDM)
Level 5 を実際に掲げたのが、アクセス管理製品を開発する StrongDM の AI チームです。2026 年 2 月 6 日に公開した「Software Factory」では、チームの規則として「コードは人が書いてはならない」「コードは人がレビューしてはならない」の 2 つを挙げています。
レビューの代わりに置いているのが検証の仕組みです。コードベースの外に保管したエンドツーエンドのユーザーストーリー(シナリオ)を、機械学習でいう評価用データのように使い、エージェントの振る舞いがシナリオを満たしているかを LLM に判定させます。合否を「テストが全部通ったか」の二値ではなく、シナリオを通した実行のうち利用者を満足させたと見込まれる割合(satisfaction)で測る、という考え方です。Okta・Jira・Slack などの外部サービスの振る舞いを再現した「Digital Twin Universe」を用意し、本番では試せない量や障害パターンでも検証しています。
この方式には外部から疑問も出ています。Simon Willison は「LLM が人間らしくない間違いをすることは皆知っているのに、なぜそれが妥当な戦略になるのか」という問いを自身のブログで投げかけ、スタンフォード大学ロースクールの CodeX は責任の所在の問題として論じています。StrongDM の取り組みは、人のレビューをやめる代わりに検証の仕組みへどれだけ投資したかを示した事例として読むのが妥当です。
人がレビューする工場(Stripe・OpenAI)
一方、量を出しながら人のレビューを残している事例もあります。Stripe は 2026 年 2 月 9 日の記事「Minions」で、社内のコーディングエージェントが書いた PR が週 1,000 件以上マージされていると公開しました。典型的な流れは Slack のメッセージで始まり、CI を通過して人のレビュー待ちになった PR で終わります。記事には「人がレビューしているが、人が書いたコードは含まない」とあります。
OpenAI が 2026 年 4 月 27 日にオープンソース化した「Symphony」は、Linear のようなプロジェクト管理ボードを、コーディングエージェントの制御盤として使うオーケストレーターです。未完了のチケットごとに専用の作業環境でエージェントを走らせ続け、止まれば再起動します。チケットのステータスが状態遷移として働くので、依存のあるタスクは順番に、独立したタスクは並列に進みます。人は優先度を決め、結果をレビューし、エージェントが起票した追加チケットを評価する役に回ります。
統制を前面に出す流れ(GitLab)
10 月に入ると、作る速さよりも統制を前面に出す発表が出てきました。GitLab は 2026 年 10 月 6 日に「governed software factory」の基盤として、ビルドに入る前のパッケージをポリシーで検査する Dependency Firewall(アーリーアクセス)や、コンテナとパッケージを一元管理する Artifact Central(ベータ)などを発表しています。AI エージェントが変更を出す速度に、レビュー・セキュリティ・承認の工程が追いつかなくなっている、という問題意識です。
ソフトウェアファクトリーを構成する工程
公開されている事例の作りは各社で異なりますが、工程に分けるとおおむね同じ並びになります。
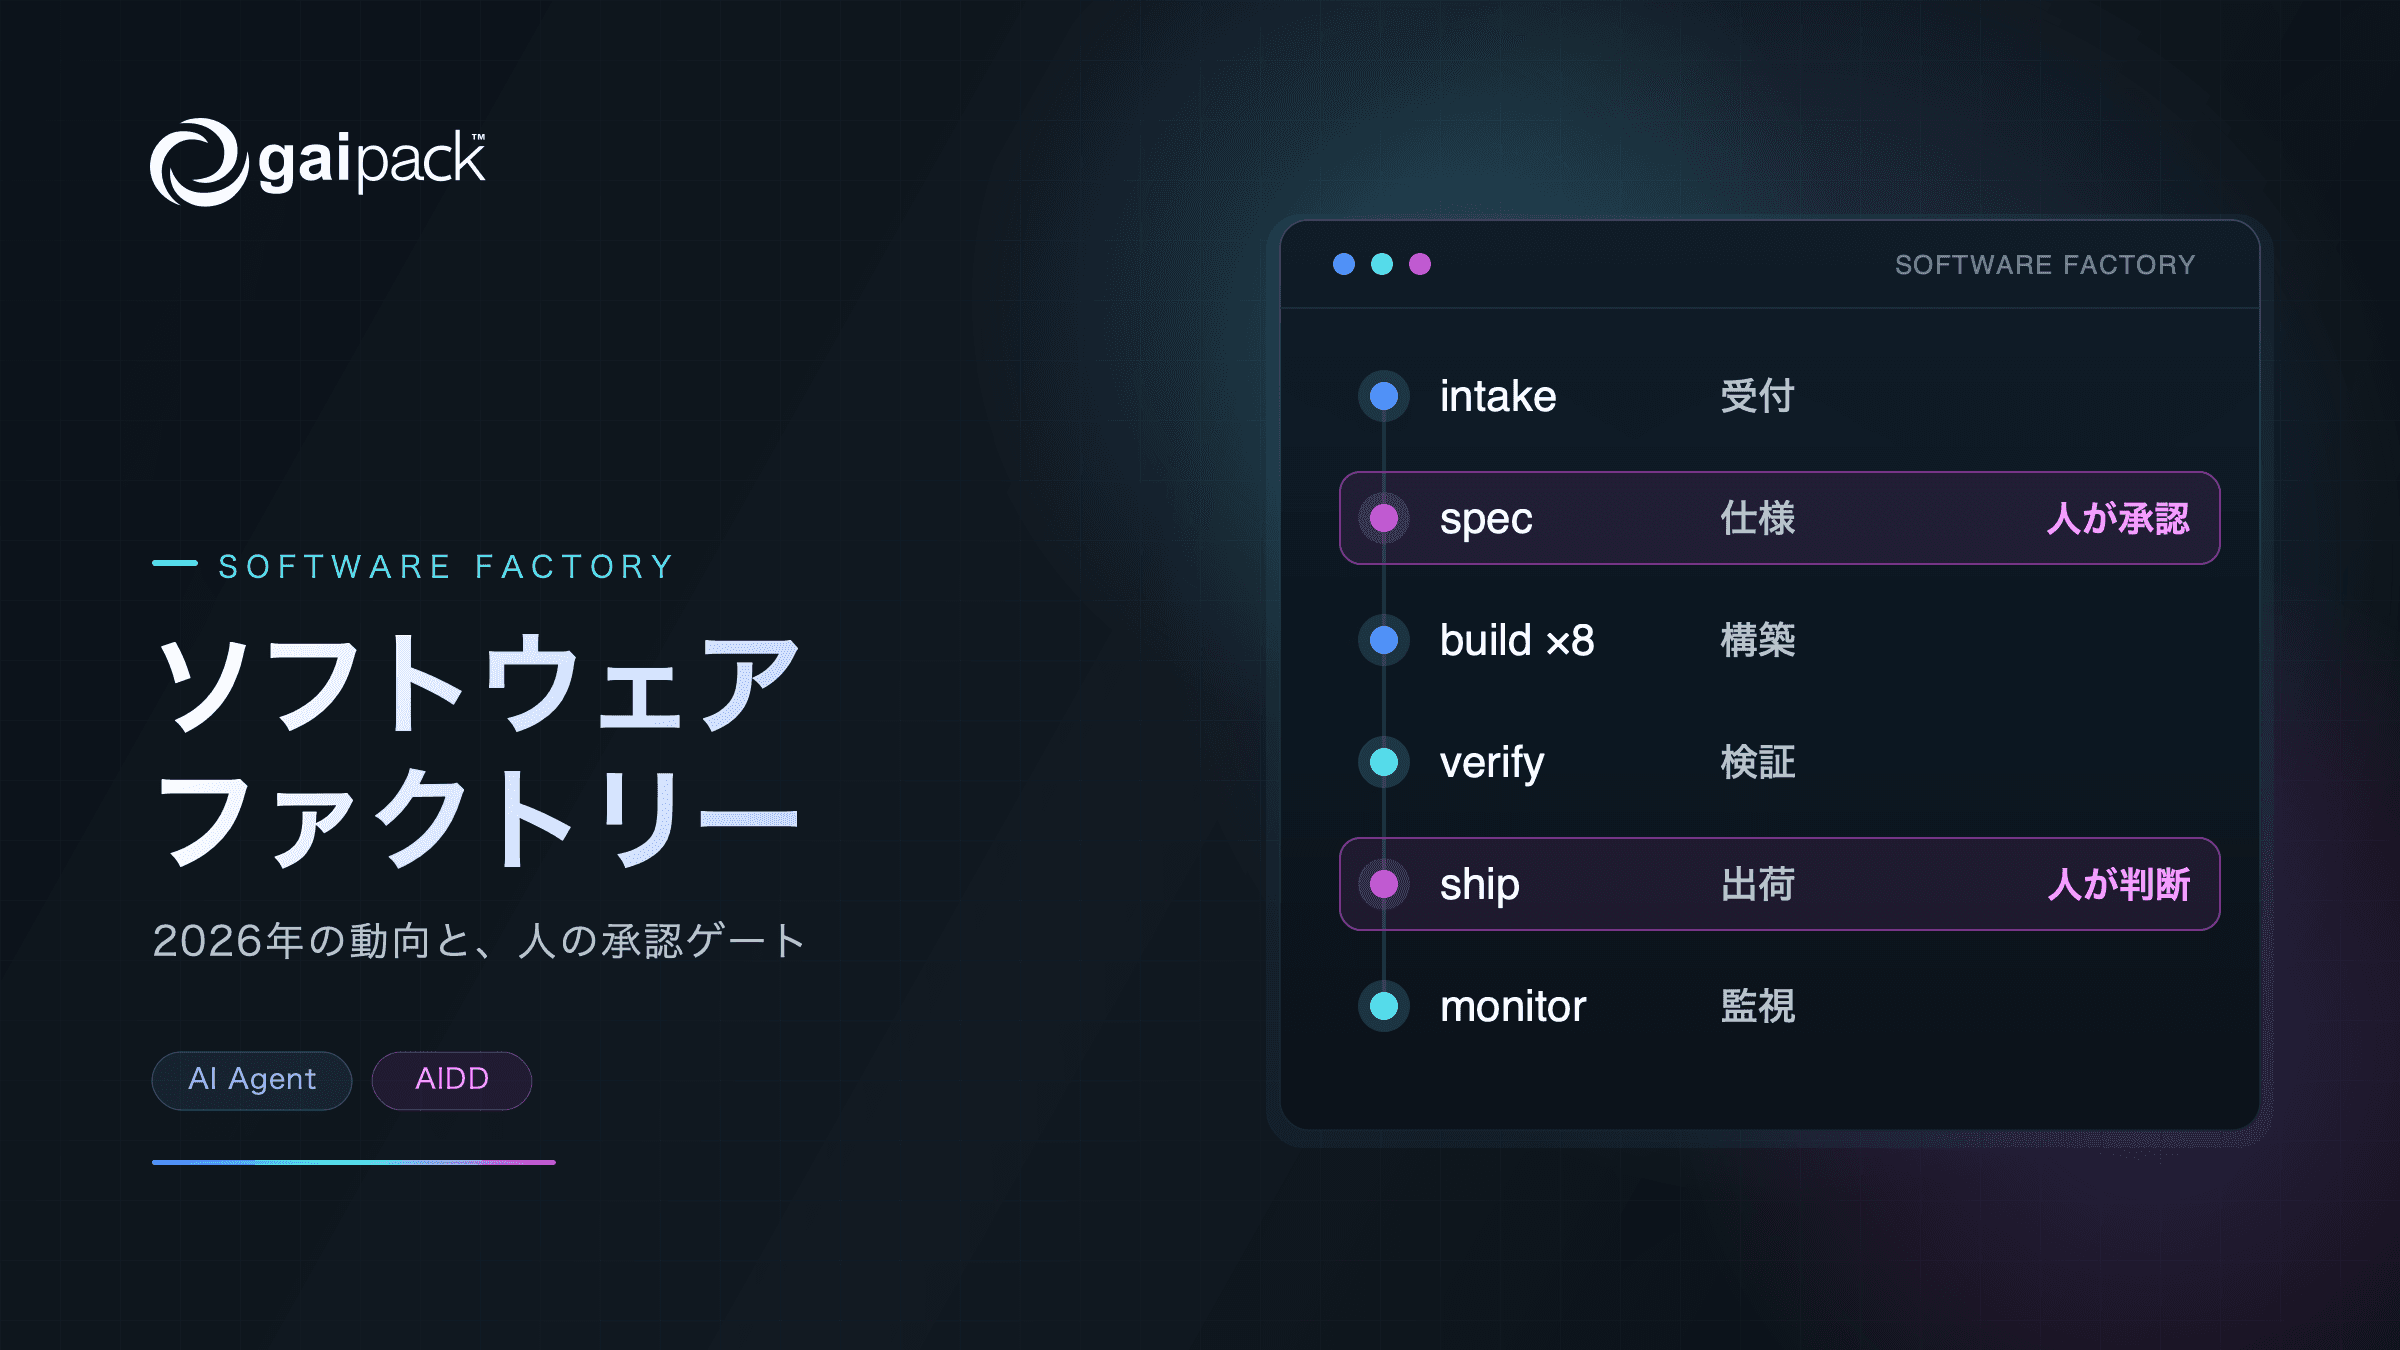
| 工程 | 入るもの | 出るもの | 主な担い手 |
|---|---|---|---|
| 受付 | Issue、Slack の依頼、障害、定期実行 | エージェントに渡せる粒度のタスク | エージェント(振り分け)+人(優先度) |
| 仕様 | タスク、既存の設計・規約 | 承認済みの仕様・受け入れ条件 | 人が承認 |
| 構築 | 承認済みの仕様 | 実装・テストコード・PR | エージェント(隔離環境で並列) |
| 検証 | PR | テスト結果、レビュー指摘、セキュリティ検査結果 | 機械検査+人 |
| 出荷 | 検証を通った PR | 本番リリース | 人が判断 |
| 監視 | 本番の挙動 | 次の受付に戻るシグナル | エージェント+人 |
構築工程では、エージェント同士が互いの作業を壊さないように隔離した環境で並列に動かします。ブランチと作業ディレクトリを分ける具体的な方法は「git worktree で AI コーディングエージェントを並列に動かす」で紹介しています。受付から監視までを 1 本の流れにつなぐことで、監視で見つかった問題がそのまま次のタスクになります。
生成から検証へ移ったボトルネック
エージェントの数を増やすと、コードを書く速さは上がります。その分、PR を検証する側の処理量が先に限界に達します。 Stripe の週 1,000 件という数字は、裏を返せば週 1,000 件のレビューが発生しているということです。
AI 導入の効果を測った調査も、速さだけでは語れないことを示しています。METR が 2025 年 7 月に公開したランダム化比較試験では、熟練したオープンソース開発者が自分のリポジトリで AI ツールを使ったとき、作業時間は 19% 長くなりました。Google Cloud の 2025 年 DORA レポートは、AI の導入がデリバリーのスループットを上げる一方で、安定性の低下とも結びついていると報告しています。
ここまでの事例は、この検証の問題に別々の答えを出しています。StrongDM はシナリオと Digital Twin Universe で検証自体を機械に寄せ、Stripe と OpenAI は人のレビューを残したまま、CI を通った PR だけを人に渡しています。GitLab は依存パッケージやシークレットの検査を工程に組み込み、人が見る前に機械で落とせるものを落とします。検査の仕組みを「ガイド」と「センサー」に分けて設計する考え方は「ハーネスエンジニアリングとは?」で詳しく解説しています。
gaipack が人の承認ゲートを残す理由
gaipack の AI駆動開発(AIDD)は、ソフトウェアファクトリーの分類でいえば、仕様と出荷の 2 か所に人の承認ゲートを置く形をとっています。AI は要件整理の補助と、設計・実装・テストのドラフト生成、整合性チェックを担い、人は判断・レビュー・承認に集中します。AIDD の方法論では、AI を「人間の判断をより正確で高速にするための支援ツール」と位置づけています。
任せる範囲をタスクの種類で決める
AIDD では、すべての工程を同じ強さで AI に任せることはしません。タスクを 6 つに分類し、どこまで AI に任せるかを決めています。
| タスク分類 | AI への任せ方 | 例 |
|---|---|---|
| 定型・反復業務 | 最も効果が大きい | テストケース生成、設計書ドラフト、API 仕様書 |
| ドキュメント生成 | 最も効果が大きい | README、運用手順書 |
| コード実装 | 既存コードと開発ルールを入力にできれば効果が大きい | 定型の CRUD 実装、データ処理 |
| 初期テスト | ケース生成は効果あり。実行は自動化が前提 | ユニットテスト、E2E のシナリオ定義 |
| 要件定義・企画 | AI は補完役 | 要件書のドラフト、提案資料の下書き |
| 意思決定・判断 | 人が判断し、AI は根拠の整理を支援 | 優先度、リスク許容度、体制 |
ソフトウェアファクトリーの工程に当てはめると、構築と検証の大部分は上の 4 分類に入り、仕様の承認と出荷の判断は下の 2 分類に入ります。承認ゲートの位置は、この分類から決まっています。
インプットの品質を先にそろえる
AIDD では、着手から完成までの期間を 2 倍以上短くできた実績がありますが、その条件としてインプットの品質が 80% 以上であることを求めています。工場に流す仕様が曖昧なままだと、エージェントはその曖昧さを埋める推測を大量に生み、検証の工程で手戻りになります。要件を固める工程そのものに AI を使う方法は AIDD 要件定義 として提供しています。
機械が見つけた差分を人が据え置く
gaipack のサイト運営でも、正本ドキュメントとサイトの記述のずれを定期的に検出する仕組みをエージェントで回しています。10 月の実行では複数のずれが見つかり、ほとんどはそのまま修正しました。ただし、講座名の改称のように研修資料の改訂が済んでいないものは、ずれと知ったうえでサイト側を据え置くと人が判断しました。
機械から見ればずれでも、直してよいかどうかは公開の時期や関係者との調整のような、リポジトリの外にある事情で決まります。シナリオやテストで表せない判断が残る限り、出荷の手前に人の承認を置いておく意味があると考えています。
自社でソフトウェアファクトリーを始める順番
いきなり工程全体をエージェントに任せる必要はありません。Shapiro の分類で Level 3 にいるチームが Level 4 に進むなら、次の順番で工程を足していくのが現実的です。
| 順番 | やること | 人の役割 |
|---|---|---|
| 1 | 受付の形式をそろえる(Issue テンプレート、受け入れ条件の書き方) | 何を受け付けるかを決める |
| 2 | 仕様を AI の入力として整える(AGENTS.md、設計書、規約) | 仕様を承認する |
| 3 | 検証を機械に寄せる(テスト、リンター、セキュリティ検査、AI レビュー) | 検査をすり抜けたものを見る |
| 4 | 構築を並列化する(隔離環境、チケットとエージェントの対応づけ) | 優先度を決める |
| 5 | 監視結果を受付に戻す | 出荷を判断する |
並列化を 4 番目に置いているのは、検証の仕組みがないまま並列化すると、レビュー待ちの PR が積み上がるだけになるためです。仕様を AI の入力として整える方法は「仕様駆動開発(SDD)とは」で、AI に作業の約束事を伝えるファイルの書き方は「AGENTS.md とは?」で紹介しています。
ソフトウェアファクトリーに関するよくある質問
導入を検討しているお客様からいただく質問をまとめました。
ソフトウェアファクトリーとダークファクトリーは同じものですか?
同じではありません。ソフトウェアファクトリーは、エージェントが工程を流す開発の仕組み全般を指します。ダークファクトリーはその中で、人がコードを書かずレビューもしない、最も自動化を進めた形を指す呼び名です。Stripe や OpenAI のように、人のレビューを残したソフトウェアファクトリーもあります。
人のレビューをなくすと何が起きますか?
レビューの代わりになる検証の仕組みがなければ、誤りがそのまま本番に出ます。StrongDM は、コードの外に保管したシナリオと外部サービスの再現環境に投資したうえでレビューをやめています。検証の仕組みを先に作り、その仕組みで落とせない誤りがどれだけ残るかを測ってから、人のレビューを減らす範囲を決めるのが安全です。
ソフトウェアファクトリーは受託開発でも使えますか?
使えますが、出荷の判断は発注元との合意が前提になります。受託開発では、仕様の承認と受け入れの判断をお客様が持つため、承認ゲートを社内だけで閉じることができません。gaipack の AIDD では、PO(お客様)が要件の優先度と受け入れを判断し、gaipack の PM が承認ゲートの運用を担う体制をとっています。
まとめ
| 観点 | 要点 |
|---|---|
| 定義 | AI エージェントが工程を流し、人が意図と承認を握る開発の仕組み |
| 系譜 | 1968 年の Bemer の提案、日本のソフトウェア工場、2004 年の Microsoft の書籍を経て、2026 年にエージェント前提で再定義 |
| 2026 年の動き | StrongDM の無人レビュー、Stripe・OpenAI の人がレビューする工場、GitLab の統制の強化 |
| ボトルネック | 生成ではなく検証。量を増やす前に検査の仕組みを作る |
| gaipack の設計 | 仕様と出荷の 2 か所に人の承認ゲートを置き、構築と検証を AI に寄せる |
自社の開発プロセスのどこに承認ゲートを置くか、どの工程から AI に寄せるかは、プロダクトの性質と体制で変わります。KDDIアイレットでは、何から始めるかの整理を gaipack コンサルティング で、自社チームへの AIDD の定着を AIDD インハウス で支援しています。お気軽にご相談ください。
※ 本記事の内容は公開時点の情報です。サービスの名称・内容・料金は予告なく改訂されることがあります。